जनरल-पर्पस फाउंडेशन मॉडल पर बने कॉल सेंटर वॉयस बॉट डोमेन शब्दों को उन दरों पर गलत पहचानते हैं जो उन्हें परिचालन रूप से अविश्वसनीय बनाते हैं। बीएफएसआई परिनियोजन में, एक बॉट जो "ईएमआई" को "सेना" के रूप में मिसर करता है या "केवाईसी पेंडिंग" को एक अनसुलझी शिकायत के रूप में व्याख्या करता है, न केवल ग्राहक को निराश करता है, बल्कि यह एक अनुपालन एक्सपोजर बनाता है। फाउंडेशन मॉडल क्या कर सकते हैं और एंटरप्राइज वॉयस एआई को वास्तव में क्या चाहिए, इसके बीच का अंतर एक त्वरित इंजीनियरिंग समस्या नहीं है। यह वास्तुकला की समस्या है।
उस अंतर को बंद करने के लिए डोमेन-विशिष्ट भाषा मॉडल मौजूद हैं। इस पोस्ट के अंत तक, आप ठीक से समझ जाएंगे कि डोमेन लैंग्वेज मॉडल किस तरह के प्रदर्शन प्रोफ़ाइल को बदल देते हैं कन्वर्सेशनल एआई वॉयस बॉट विनियमित उद्योगों के लिए यह क्यों मायने रखता है, और जब यह काम करता है तो आर्किटेक्चर कैसा दिखता है।
कन्वर्सेशनल एआई वॉयस बॉट्स में जेनेरिक फाउंडेशन मॉडल क्या गलत हो जाते हैं
फाउंडेशन मॉडल को व्यापक इंटरनेट कॉर्पोरा पर प्रशिक्षित किया जाता है। वे सामान्य भाषा की समझ में उत्कृष्ट हैं लेकिन डोमेन अस्पष्टता में कमजोर हैं, विशेष रूप से आवाज के संदर्भों में जहां एएसआर (स्वचालित भाषण पहचान) पहले परिवर्तित होता है टेक्स्ट के लिए भाषण इससे पहले कि कोई भी भाषा प्रसंस्करण हो।
आवाज एआई में दो विफलता बिंदु यौगिकः
सामान्य शब्दों के साथ ध्वनिक समानता के कारण एएसआर लेयर किसी डोमेन शब्द को गलत तरीके से ट्रांसक्रिप्ट कर सकती है।
डाउनस्ट्रीम भाषा मॉडल में संदर्भ से इसे ठीक करने के लिए योजना की कमी हो सकती है, भले ही त्रुटि पुनर्प्राप्त करने योग्य हो।
बैंकिंग आईवीआर में, "एनएसीएच जनादेश" और "एनएटीसीएच जनादेश" एक सामान्य एएसआर प्रणाली के समान लगते हैं। बैंकिंग शब्दावली पर प्रशिक्षित एक डोमेन भाषा मॉडल संदर्भ से इसे हल करता है। एक सामान्य नहीं है।
कॉल सेंटर वॉयस बॉट परिनियोजन का परिणाम उच्च गलत पहचान दर, बढ़े हुए एजेंट एस्केलेशन वॉल्यूम और सेल्फ-सर्विस टचप्वाइंट पर ग्राहक परित्याग है। एंटरप्राइजेज आमतौर पर इसे मॉडल आर्किटेक्चर के लिए जिम्मेदार नहीं ठहराते हैं, जिसका मतलब है कि मूल कारण का पता नहीं चलता है, जबकि सीएक्स टीमें लक्षण-स्तर के सुधारों का पीछा करती हैं।
कन्वर्सेशनल एआई के लिए डोमेन लैंग्वेज मॉडल कैसे बनाए जाते हैं
एक डोमेन लैंग्वेज मॉडल एक छोटा, फाइन-ट्यून मॉडल है जो एक उद्योग वर्टिकल के लिए विशिष्ट क्यूरेटेड डेटा पर प्रशिक्षित होता है। बीएफएसआई में, इसका मतलब है लोन प्रलेखन, नियामक परिपत्र, उत्पाद प्रकटीकरण विवरण, संग्रह स्क्रिप्ट और शिकायत पत्राचार। मॉडल शब्दावली, वाक्य रचना पैटर्न और महत्वपूर्ण रूप से, आशय वर्गीकरण को सीखता है जो परिभाषित करता है कि ग्राहक वास्तव में उस डोमेन में समस्याओं को कैसे व्यक्त करते हैं।
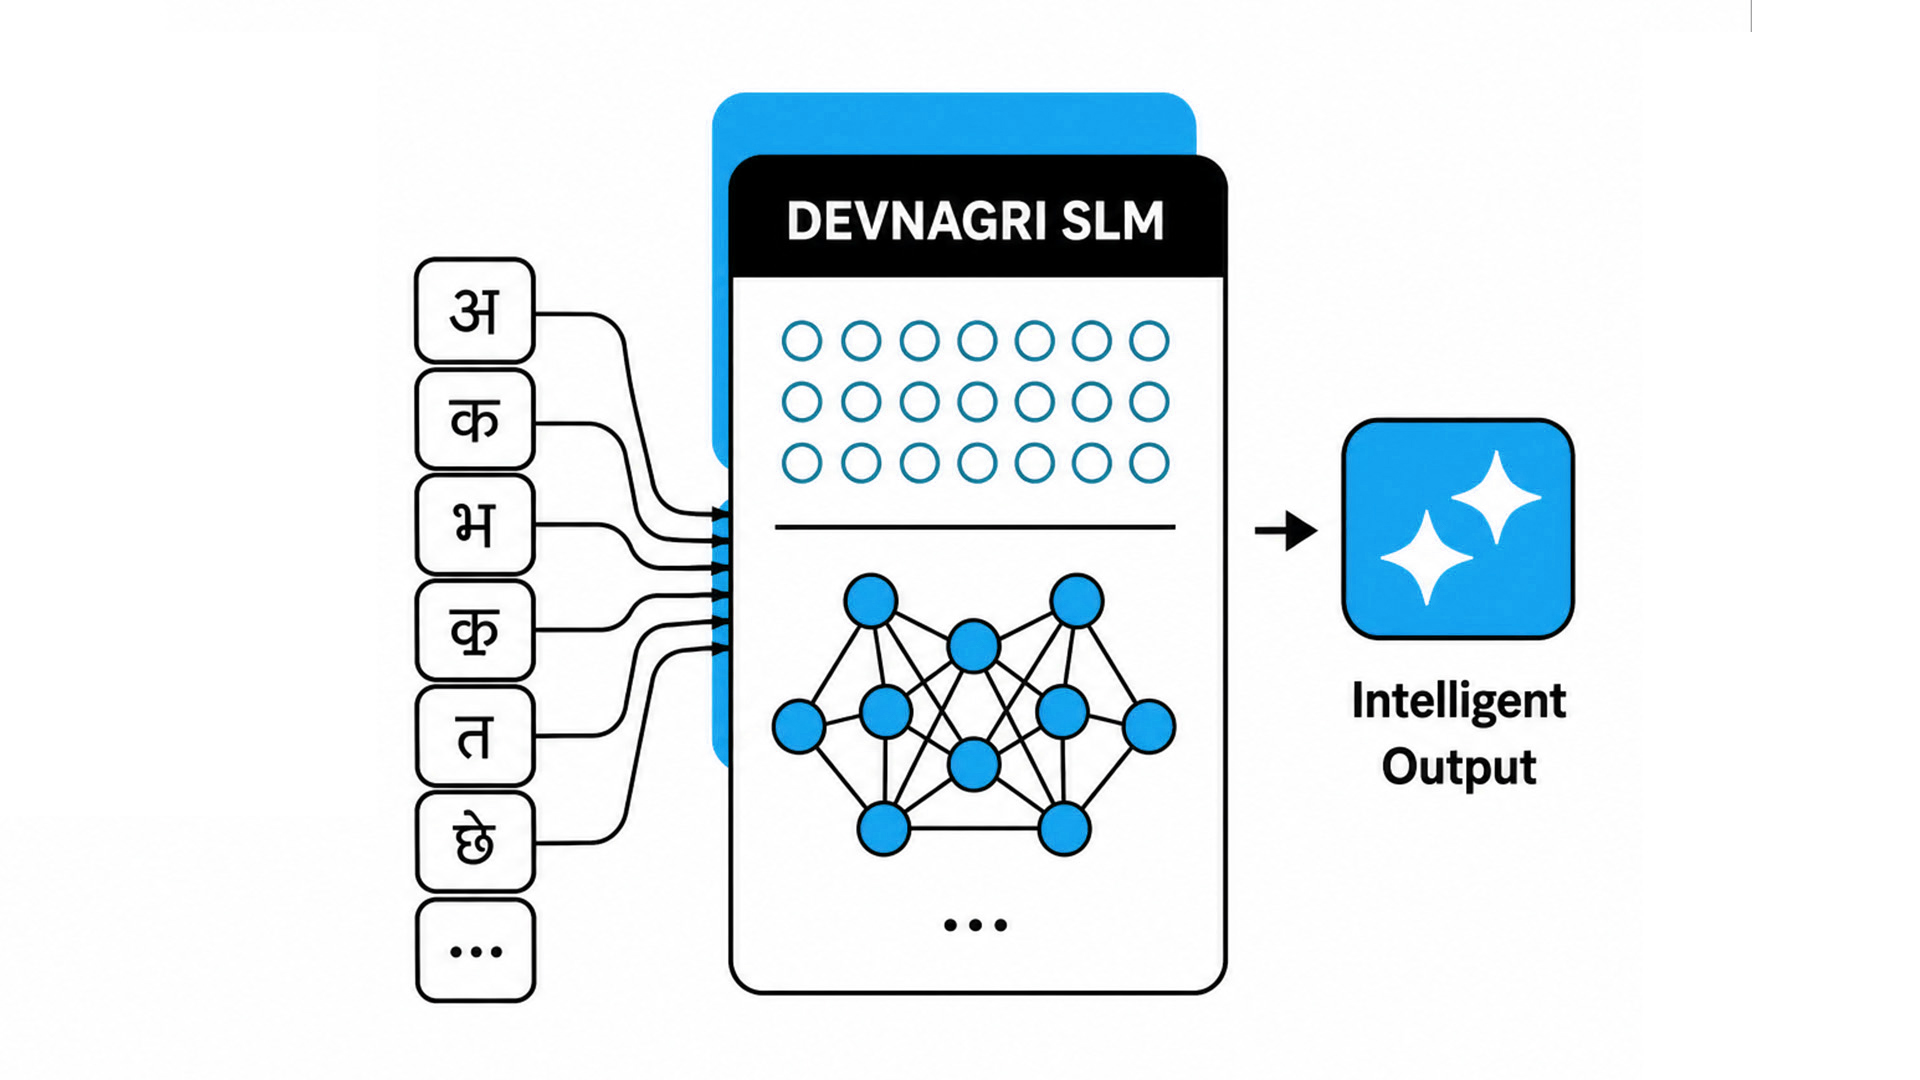
बीएफएसआई के लिए देवनागरी का डोमेन SLMs न केवल अंग्रेजी वित्तीय पाठ पर बल्कि भारतीय भाषाओं में प्रशिक्षित किया जाता है, जिसमें क्षेत्रीय बोलियां भी शामिल हैं, जहां वित्तीय शब्दावली अक्सर अंग्रेजी और स्थानीय भाषा के मध्य वाक्य के बीच कोड-स्विच करती है। राजस्थान में मेवाड़ी से प्रभावित हिंदी बोलने वाले एक ग्राहक को संभालने वाले कलेक्शन बॉट को एक भाषा मॉडल की आवश्यकता होती है जो उस कोड-स्विच किए गए इरादे को पहचानता है, न कि एक सामान्य जो उच्चारण को अस्पष्ट बताता है।
इस विशेषज्ञता का मतलब है कि छोटे मॉडल डोमेन-विशिष्ट वॉयस टास्क पर बहुत बड़े सामान्य-उद्देश्य वाले मॉडल से बेहतर प्रदर्शन करते हैं, जिसमें कम विलंबता और कम कंप्यूट लागत होती है।
वार्तालाप एआई आवाज सटीकता में एएसआर गुणवत्ता की भूमिका
इससे पहले कि कोई डोमेन लैंग्वेज मॉडल अपना काम कर सके, एक एएसआर इंजन को कॉल करने वाले ने जो कहा उसका सटीक ट्रांसक्रिप्ट तैयार करना होगा। मुख्य रूप से अंग्रेजी या मानक हिंदी पर प्रशिक्षित जेनेरिक एएसआर सिस्टम क्षेत्रीय भारतीय भाषा के इनपुट पर खराब प्रदर्शन करते हैं, विशेष रूप से पृष्ठभूमि शोर, बोली भिन्नता और मिश्रित-लिपि उच्चारण के साथ टेलीफोनी-ग्रेड ऑडियो में।
एंटरप्राइज-ग्रेड कन्वर्सेशनल एआई वॉयस इंफ्रास्ट्रक्चर को डोमेन-ट्यून्ड एएसआर लेयर को डोमेन लैंग्वेज मॉडल के साथ जोड़ना चाहिए। एक दूसरे के बिना एक भंगुर प्रणाली बनाता हैः
एक कम शक्ति वाले भाषा मॉडल को खिलाने से आपको सटीक ट्रांसक्रिप्शन मिलता है जो बॉट सही ढंग से व्याख्या नहीं कर सकता है।
कमजोर एएसआर के डाउनस्ट्रीम में एक शक्तिशाली भाषा मॉडल शुरू से ही दूषित इनपुट प्राप्त कर रहा है।
एआई-सहायता प्राप्त सार्वजनिक सेवाओं पर डीईआईटीवाई रिपोर्ट ने भारतीय भाषाओं में एएसआर सटीकता को एक प्राथमिक परिनियोजन बाधा के रूप में चिह्नित किया, न कि मॉडल इंटेलिजेंस के रूप में। कॉल सेंटर वॉयस बॉट समाधानों का मूल्यांकन करने वाले संगठनों को लक्षित भाषाओं में एएसआर गुणवत्ता को एक गैर-परक्राम्य प्रथम मानदंड के रूप में मानना चाहिए।
वार्तालाप एआई बॉट्स को एक सांस्कृतिक बुद्धिमत्ता परत की आवश्यकता क्यों है
अकेले भाषा की समझ उचित आवाज एआई व्यवहार का उत्पादन नहीं करती है। महाराष्ट्र में एक कलेक्शन बॉट और तमिलनाडु में एक कलेक्शन बॉट एक ही सांस्कृतिक संदर्भ में काम नहीं कर रहे हैं, भले ही दोनों बातचीत एक मिस्ड ईएमआई के बारे में हों। स्वर, औपचारिकता रजिस्टर, स्वीकार्य मुखरता के स्तर, और स्व-सेवा से मानव एजेंट तक बढ़ने का सही समय सभी क्षेत्र के अनुसार भिन्न होते हैं।
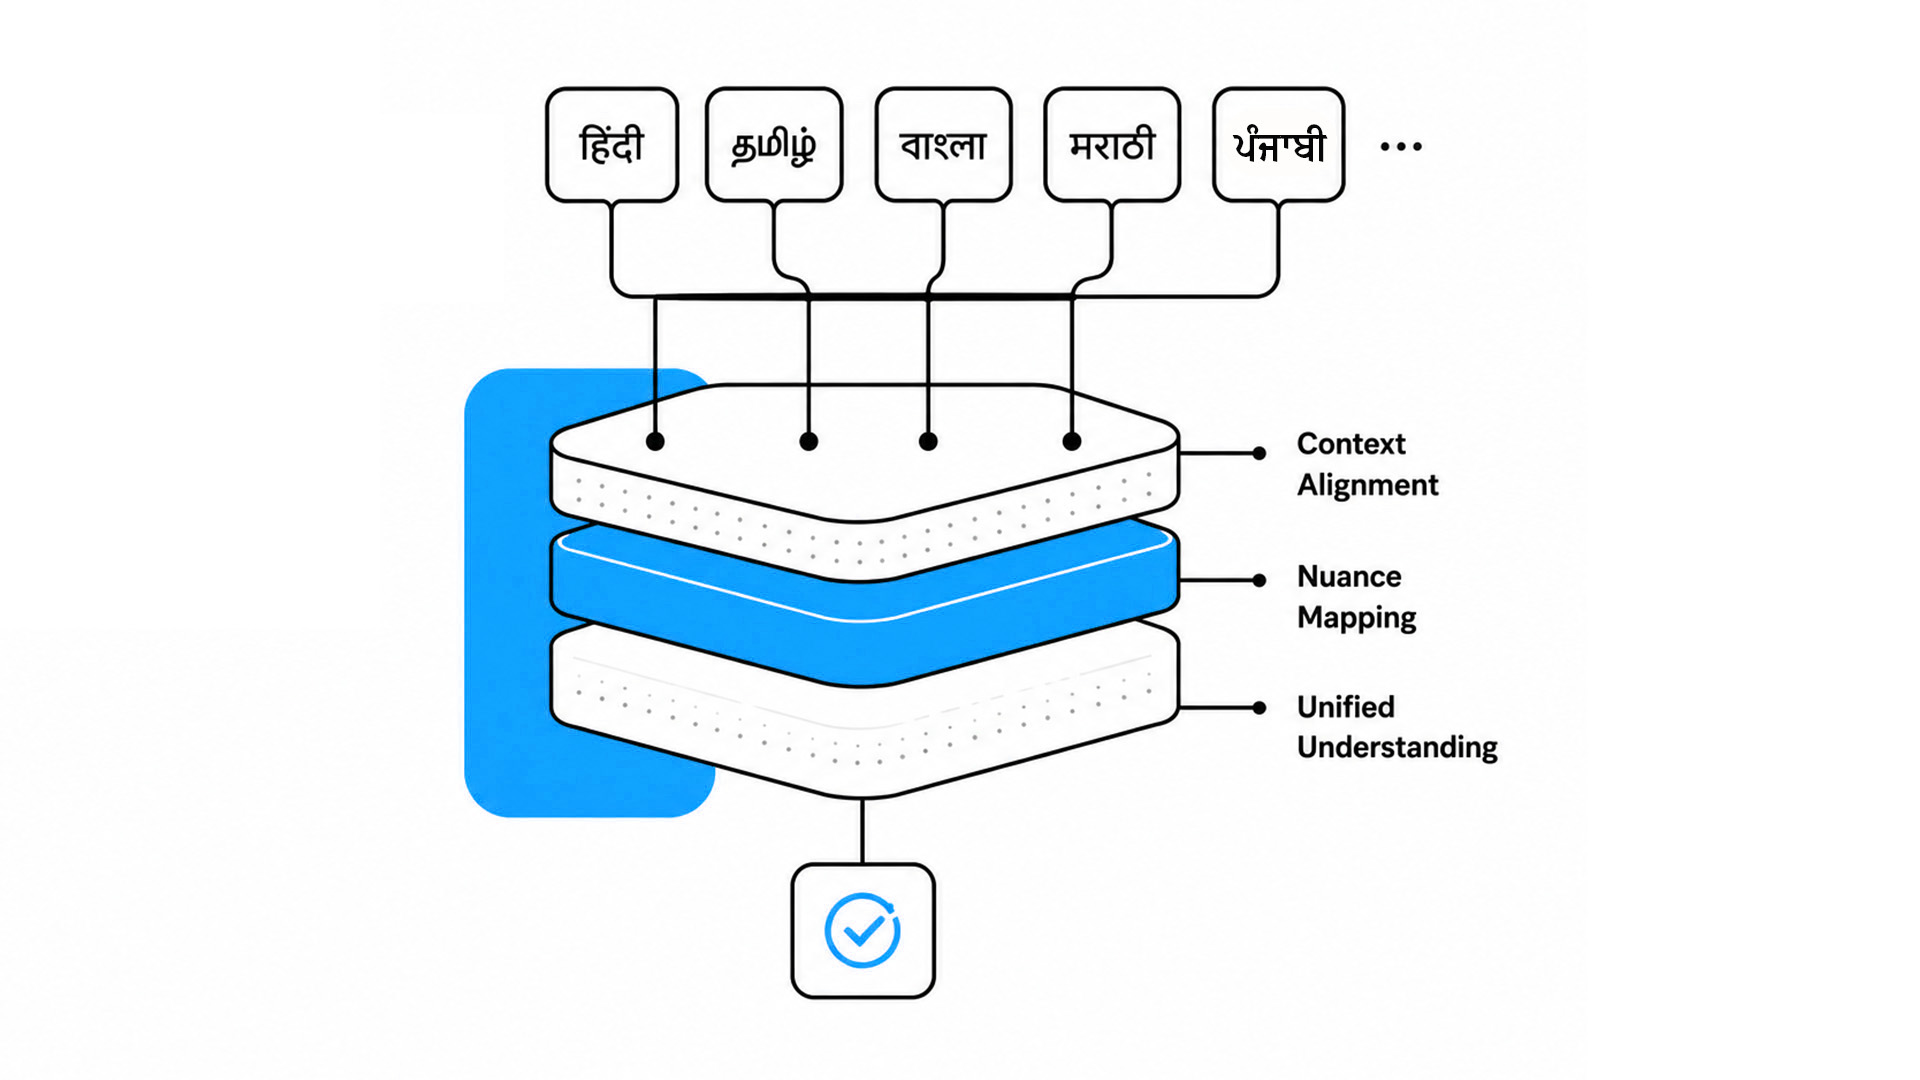
A cultural intelligence layer sits above the domain language model and governs how outputs are constructed. In Devnagri's architecture, this includes a tone engine that calibrates output between soft, firm, and reminder modes based on prior interaction history, account status, and regional norms. The आप versus तुम distinction in Hindi-language voice output is not a stylistic preference; in a collections context, it affects right-party contact rates and customer sentiment at a statistically meaningful level.
संगठन जो इसे अनुवाद समस्या के रूप में मानते हैं, ऐसे बॉट तैनात करते हैं जो सही भाषा बोलते हैं लेकिन गलत संदर्भ बोलते हैं। परिणाम ग्राहक विघटन और वृद्धि की मात्रा है जो वॉयस एआई के लिए लागत मामले को पूरी तरह से नकारती है।
कॉल सेंटर वॉयस बॉट आर्किटेक्चर: वास्तव में उद्यम परिनियोजन की क्या आवश्यकता है
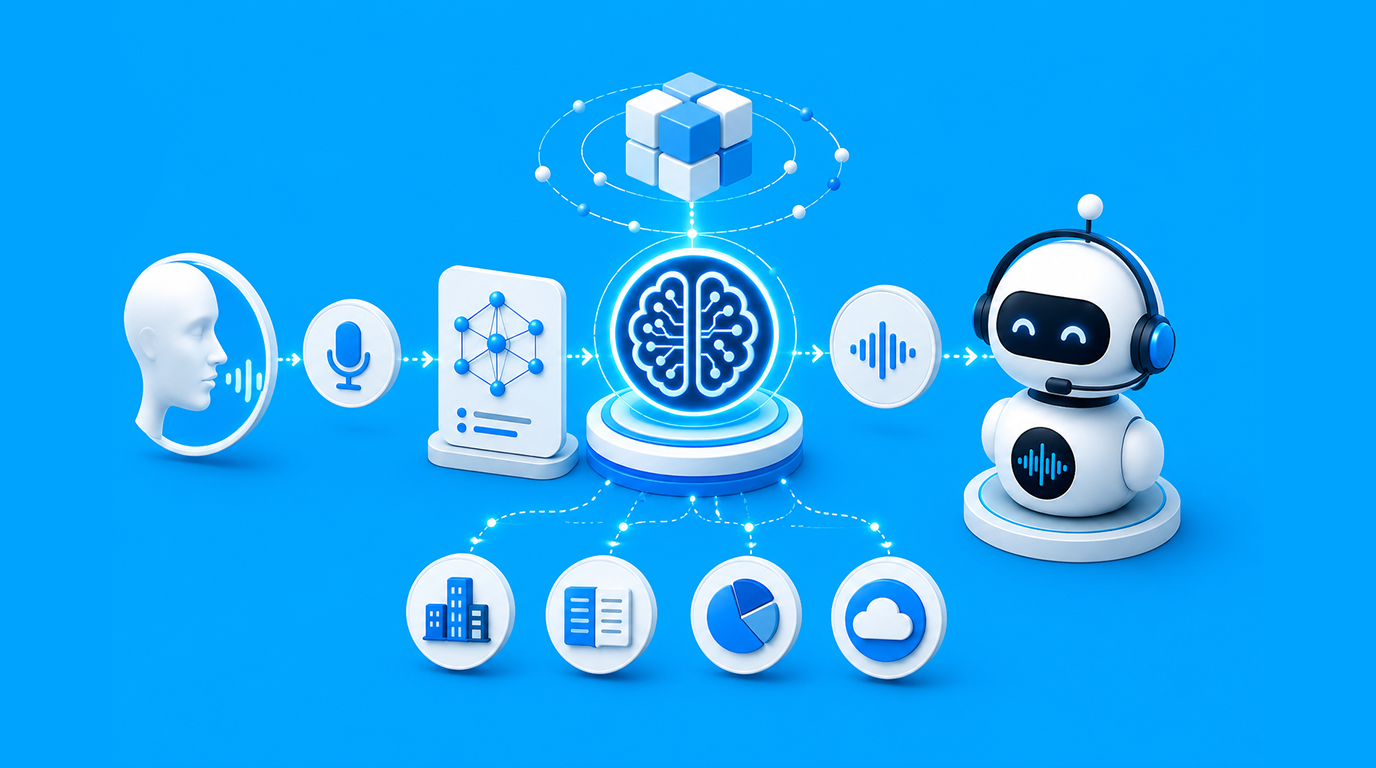
A production-grade call center voice bot is not a single model. It is an orchestrated stack, and each component must be governed with every handoff logged:
- टेलीफोनी एकीकरण , इनबाउंड कॉल रूटिंग और आईवीआर ट्रिगर
- एएसआर लेयर , डोमेन-ट्यून, भाषा-विशिष्ट स्पीच-टू-टेक्स्ट
- डोमेन भाषा मॉडल , आशय वर्गीकरण और इकाई निष्कर्षण
- इंटेंट राउटर , स्व-सेवा समाधान या मानव वृद्धि तर्क
- टीटीएस लेयर , कॉलर की भाषा में प्राकृतिक, टोन-नियंत्रित वॉयस आउटपुट
- सीआरएम/कोर बैंकिंग एकीकरण , प्रति बातचीत वास्तविक समय खाता संदर्भ खींचा जाता है
- ऑडिट लॉग , ट्रांसक्रिप्ट, मॉडल संस्करण, वर्गीकरण और परिणाम का अपरिवर्तनीय रिकॉर्ड
विनियमित क्षेत्रों के लिए, ऑडिट लेयर वैकल्पिक नहीं है। आरबीआई के डिजिटल लेंडिंग दिशानिर्देशों के लिए आवश्यक है कि एआई-मध्यस्थ ग्राहक बातचीत पूरी ट्रेसेबिलिटी बनाए रखे। एक वॉयस बॉट जो हर कॉल की अपरिवर्तनीय प्रतिलेख का उत्पादन नहीं कर सकता है, अनुपालन नहीं करता है, भले ही वह कॉल को कितनी अच्छी तरह से संभालता हो।
देवनागरी का कन्वर्सेशनल एआई इंफ्रास्ट्रक्चर में कॉन्फ़िगर करने योग्य ऑडिट लॉग पॉलिसियों के साथ ज़ीरो-डेटा-रिटेंशन डिफ़ॉल्ट शामिल हैं, डेटा निवास आवश्यकताओं वाले संगठनों के लिए वीपीसी और ऑन-प्रिमाइसेस परिनियोजन विकल्प, और कोर बैंकिंग और सीआरएम प्रणालियों में एकीकरण मार्ग।
यह मापना कि कन्वर्सेशनल एआई वॉयस बॉट्स वास्तव में क्या सुधार करते हैं
वॉयस बॉट्स को अक्सर गलत मेट्रिक्स पर मापा जाता है: कॉल सेंटर स्तर पर कंटेनमेंट दर और औसत हैंडल समय। वे मेट्रिक्स आपको बताते हैं कि क्या बॉट ने बातचीत को संभाला है, न कि क्या उसने इसे अच्छी तरह से संभाला है। एक बॉट जो गलत वर्गीकृत परिणामों के माध्यम से कॉल के 80% को हल करता है, ग्राहकों के विश्वास को कम करते हुए नियंत्रण को बढ़ाता है।
एंटरप्राइज परिनियोजन में कन्वर्सेशनल एआई वॉयस बॉट्स के लिए सही माप फ्रेम में शामिल हैंः
प्रथम-संपर्क समाधान दर, भाषा खंड द्वारा, कुल नहीं
पोस्ट-कॉल एनपीएस, भाषा और आशय श्रेणी द्वारा विभाजित
प्रति आशय वृद्धि दर, उपयोग-मामले के स्तर पर फ्लैग मॉडल विफलता बिंदु
विनियामक अनुपालन घटना दर, प्रति हजार बातचीत, प्रति तिमाही नहीं
Organizations that track these metrics see domain language models outperform generic alternatives by margins that justify the infrastructure investment. Devnagri's collections voice bot deployments in BFSI have produced 20-30% improvement in collections response rates, driven primarily by language-appropriate engagement rather than scripting changes.
कैसे वार्तालाप एआई वॉयस इंफ्रास्ट्रक्चर भाषाओं में स्केल करता है
भारत की भाषाई विविधता एंटरप्राइज वॉयस एआई के लिए यूएक्स विचार नहीं है; यह एक बुनियादी ढांचे की आवश्यकता है। 18 राज्यों में ग्राहकों के साथ एक बैंक कम से कम आठ प्राथमिक भाषाओं और दर्जन भर क्षेत्रीय बोलियों में काम कर रहा है। एक कॉल सेंटर वॉयस बॉट जो हिंदी और अंग्रेजी को संभालता है लेकिन तमिल, तेलुगु, मराठी या बंगाली को नहीं संभालता है, भाषा एआई परिनियोजन नहीं है, यह आंशिक है।
स्केलिंग कन्वर्सेशनल एआई वॉयस कवरेज के लिए प्रति भाषा प्रशिक्षित डोमेन भाषा मॉडल की आवश्यकता होती है, न कि भाषा-स्विचिंग लॉजिक के साथ एक भी मॉडल। प्रत्येक भाषा डोमेन मॉडल को उस भाषा में एएसआर सटीकता के लिए कैलिब्रेट किया जाना चाहिए, उस भाषा में आशय वर्गीकरण, और टेक्स्ट टू स्पीच (टीटीएस) उस भाषा में आवाज की गुणवत्ता। जो संगठन खरीद से पहले इस आर्किटेक्चर का आकलन करते हैं, वे महंगे पुनर्निर्माण से बचते हैं जो एक संकीर्ण भाषा परिनियोजन का अनुसरण करता है जो वास्तविक ग्राहक आधार की सेवा करने में विफल रहता है।
निष्कर्ष
डोमेन भाषा मॉडल वार्तालाप एआई वॉयस बॉट्स के लिए एक वृद्धि नहीं हैं, वे वास्तुकला निर्णय हैं जो यह निर्धारित करते हैं कि एक वॉयस बॉट परिनियोजन विनियमित उद्यम वातावरण में प्रदर्शन करता है या विफल होता है। जेनेरिक फाउंडेशन मॉडल डोमेन संदर्भ, क्षेत्रीय भाषा की गहराई, या शासन मुद्रा की आपूर्ति नहीं कर सकते हैं जिसकी बीएफएसआई और इसी तरह विनियमित क्षेत्रों को आवश्यकता होती है। टिकाऊ आवाज एआई क्षमताओं का निर्माण करने वाले संगठन इसे एक बुनियादी ढांचे के निर्णय के रूप में मान रहे हैं, न कि सॉफ्टवेयर चयन के रूप में।
यदि आपका संगठन क्षेत्रीय भाषा परिनियोजन के लिए कॉल सेंटर वॉयस बॉट विकल्पों का मूल्यांकन कर रहा है, तो डोमेन एस. एल. एम. आर्किटेक्चर और बी. एफ. एस. आई. से लाइव परिनियोजन उदाहरणों की समीक्षा करने के लिए देवनागरी के साथ एक प्लेटफॉर्म वॉकथ्रू बुक करें।
एक वॉयस बॉट जो आपके ग्राहक को नहीं समझ सकता है, वह एआई समस्या नहीं है, यह एक डेटा और आर्किटेक्चर समस्या है जिसे कोई भी मात्रा में संकेत ठीक नहीं करेगा।